AI 영상 제작과 관심사의 분리(SoC)
화장품 제품 링크로 15초짜리 광고를 만들어보려고 했습니다. 검색을 좀 해봤더니 Claude + Higgsfield(Seedance 2.0) 조합으로 한 채팅 안에서 기획, 콘티, 영상까지 하는 것에 많은 레퍼런스가 있었고, 저도 따라서 아래의 순서로 영상을 제작했습니다.
- 인물 마스터시트 제작: 정면샷, 얼굴, 측면샷, 표정 변화 등을 포함 (GPT Image 2)
- 실사기반 콘티 제작: 영상에 스토리라인을 결정. 주로 위의 마스터시트의 인물을 활용 (GPT Image 2)
- 영상 제작: Higgsfield 와 같은 MCP 기반 영상 제작
그런데 렌더(3단계)를 돌릴 때 원하는 수준의 결과물이 나오지 않았습니다. 컷마다 유리잔이 다른 잔이 되고, 사람 얼굴도 바뀌고, 무엇보다 Seedance가 립스틱 디자인이랑 열림/닫힘 상태를 계속 틀렸어요. (학습 데이터에 그 제품이 있었을 리가 없죠.) 그리고 “유리잔을 똑바로 들고 입술을 대는” 포즈는 아무리 고쳐도 마시는 포즈로 나왔습니다. (아마 학습 데이터에는 컵의 물을 마시는 영상이 많았을 겁니다.)
원인 분석
비디오 모델에게 여러 컷으로 된 광고를 부탁한다는 건, 사실 서로 다른 종류의 정보를 한꺼번에 던진다는 뜻입니다.
- 구조: 무엇이 어떤 순서로 일어나는가
- 외형: 사람, 제품, 소품이 어떻게 생겼는가
- 계약: 정확한 첫 프레임과 마지막 프레임
- 움직임: 어떻게 움직이는가
이걸 전부 텍스트 프롬프트 하나에 밀어 넣으면(제가 처음에 그렇게 했습니다) 모델이 슬슬 제 의도와는 상관없는 방향으로 갑니다. 처음에는 자동승인 모드로 돌려보았고 90점을 줄만한 수준까지는 정말 빠른 속도로 도달하는데 여기서부턴 헬 난이도로 가더군요. 아쉬웠던 디테일은 주로 모델의 피부가 일정하지 않거나(점의 위치나 개수), 투명 유리컵이나 립의 디테일이었어요. Claude Fabric 모델과 함께 했는데 본인도 리뷰를 하면서 계속 프롬프트를 보완하더군요. 점점 프롬프트와 단계, 그리고 Seedance 에게 줄 레퍼런스 이미지가 늘어나는데도 99점은커녕 95점 이상도 줄 수 있는 결과물이 나오지 않았습니다.
예를 들어, 인물의 피부톤이 변했는데요. Seedance 에 제공하는 인물 묘사 프롬프트에 natural moles, visible pores 같은 피부 묘사가 있었는데(Claude Fabric 이 작성), 텍스트 프롬프트가 레퍼런스 이미지를 이겨버린 거예요. 실제로는 외형이 이미지에서만 와야 하는데, 텍스트로 다시 설명하니 그 특징이 랜덤하게 더해졌습니다.
레퍼런스가 보여주는 걸 텍스트로 다시 묘사하지 말자
처음부터 다시 시작: 관심사의 분리(Separation of Concerns)
핵심은 정보의 종류마다 가장 잘 담기는 형식이 존재합니다. 프로그래밍에서 말하는 관심사의 분리(Separation of Concerns)와 똑같아요. 하나의 책임은 하나한테만 맡깁니다. 위에 예시처럼 인물의 피부에 대해서는 레퍼런스 이미지가 외형을 담당해야지 텍스트나 콘티 같은 다른 요소로 묘사하지 않는 겁니다. SOLID의 SRP(단일 책임 원칙)가 클래스에 하나의 책임만 주듯이, 여기서도 각 레퍼런스는 딱 하나만 맡습니다. 구조는 구조만, 외형은 외형만요.
| 요소 | 담는 것 | 형식 |
|---|---|---|
| 콘티 | 컷 순서, 프레이밍, 타이밍, 카메라 | 주석 달린 스케치 콘티 |
| 이미지 | 사람, 제품, 소품의 생김새 | 라벨이 붙은 실사 사진 시트 |
| 앵커 | 첫 프레임과 마지막 프레임 | 시작/끝 키프레임 앵커 |
| 움직임 | 손동작, 모션 | 공식 사용 영상(--video) |
| 텍스트 | 액션, 카메라, 타이밍만 | 프롬프트(외형 재묘사 없음) |
말은 간단한데, 여기까지 오는데 이틀은 족히 걸린 것 같습니다. 역할을 분리해야 한다! 까지만 이해해주시고 자세한 건 다음 섹션부터 다루겠습니다.
콘티는 실사가 아닌 스케치로
등장인물 마스터시트를 제작한 다음에는 이 등장인물이 실제로 포함하는 콘티 시트를 넣었습니다. 사람이 보기엔 그럴듯하지만, 비디오 AI에게는 두 번째 마스터시트 로 작용하더라고요. 콘티에 그려진 얼굴이 캐릭터 레퍼런스를 오염시켰고(“유사하지만 다른 사람” 등장), 소품 상태도 일관성이 없었습니다. 전체적인 스토리라인만 잡으려고 했던 콘티인데, 비디오 모델이 이걸 이미지로 받아들이면서 원하지 않았던 상호작용이 된 것입니다.
이 문제를 해결하기 위해 많은 블로그 포스팅과 논문도 살펴봤는데요. 제 결론은 연필 스케치로 바꾸는 것이었습니다. 스케치에는 외형 정보가 없으니, 모델이 그림을 재현할 대상으로 읽지 않고 주석을 지시사항으로 읽습니다.
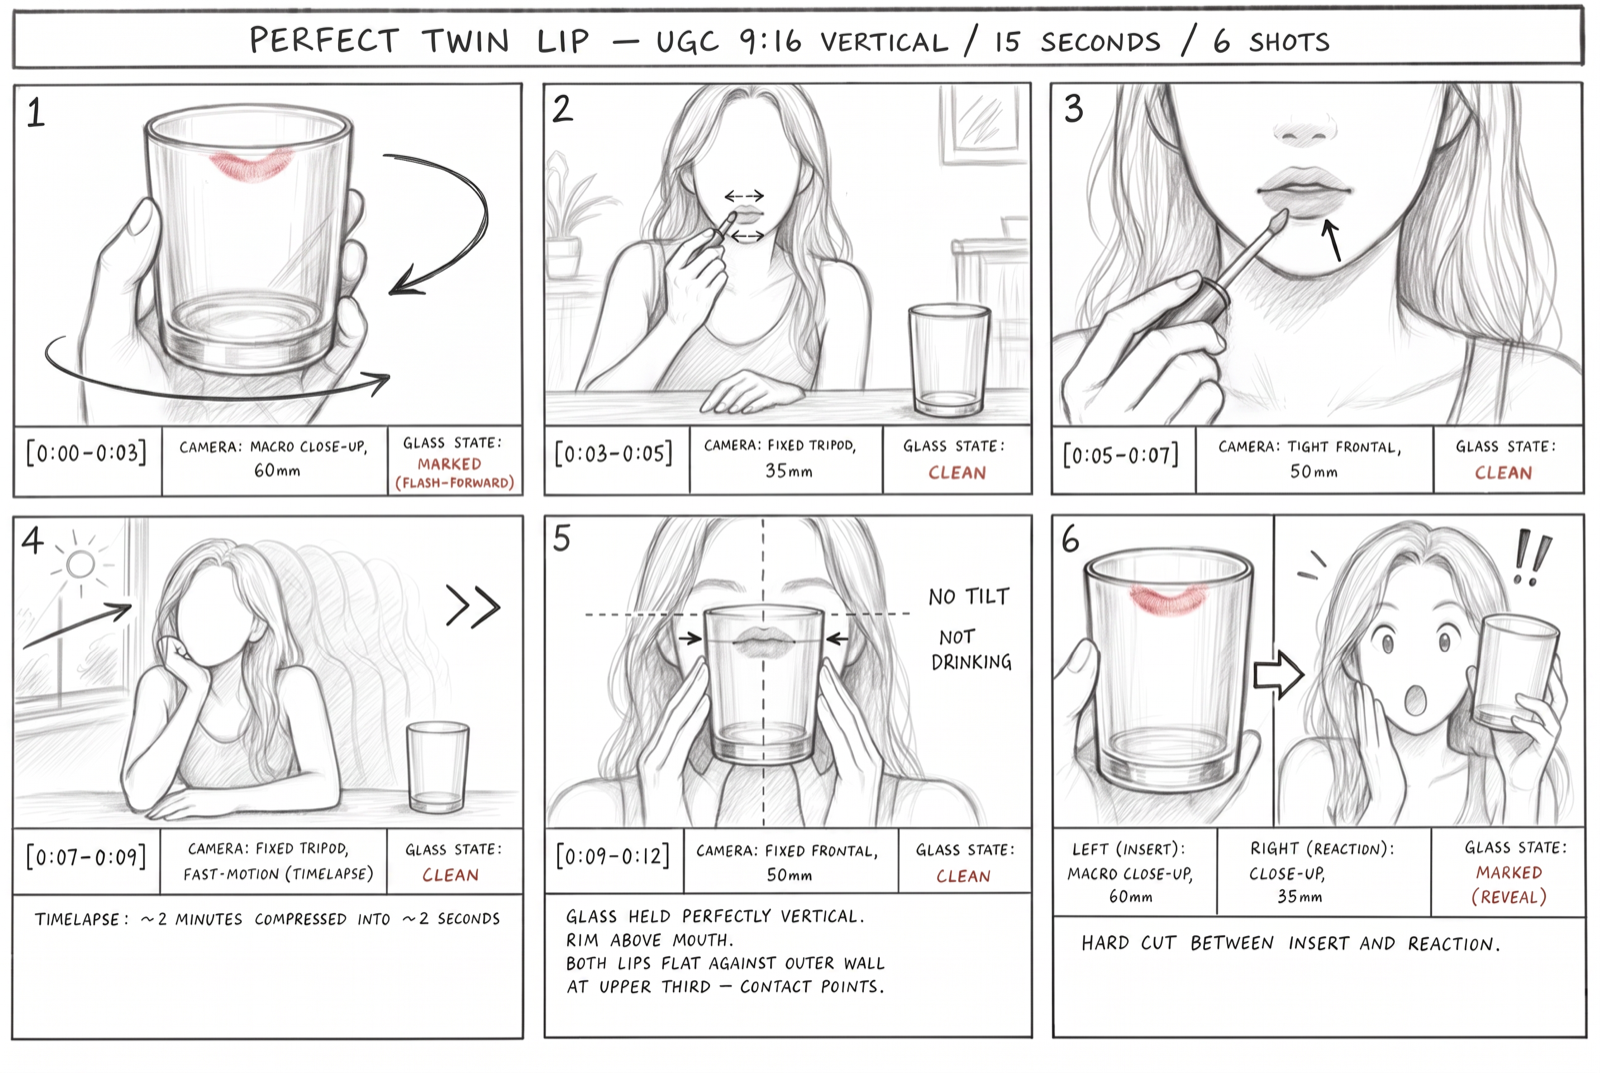
이건 연구 쪽에서도 근거가 있습니다. DrawVideo는 각 샷의 조건을 흑백 스케치(구도/레이아웃) / 외형 프롬프트 / 모션 프롬프트로 나누는 걸 설계의 전제로 삼습니다. 스케치는 처음부터 외형의 기준이 아니었던 거죠. 한 실전 워크플로우 글에서도 단일 이미지 방식은 “랜덤 점프 컷” 때문에 다섯 번 넘게 실패했지만, 타임라인 주석이 있는 스토리보드는 첫 시도에 성공했다고 합니다. 전통 애니메이션 보드가 썸네일 단계에서 일부러 디테일을 포기하고 카메라와 구도만 고정하는 것도 같은 이유입니다.
그리고 콘티를 스케치 형태로 하게 되면서 콘티 제작과 마스터시트 제작의 순서를 변경했습니다. 이렇게 생각한 이유는 콘티를 완성해야 주요 등장인물과 주요 사물에 대한 정의를 할 수 있다고 생각했기 때문이었고, 이것도 매우 중요한 변경 사항이었습니다. 콘티를 작성하고 나니 좀 더 등장인물에 대한 캐릭터나 표정과 의상, 주요 사물을 뭘 골라야 하고 사물의 특정 상태를 마스터시트로 정의해야 할지 보였습니다.
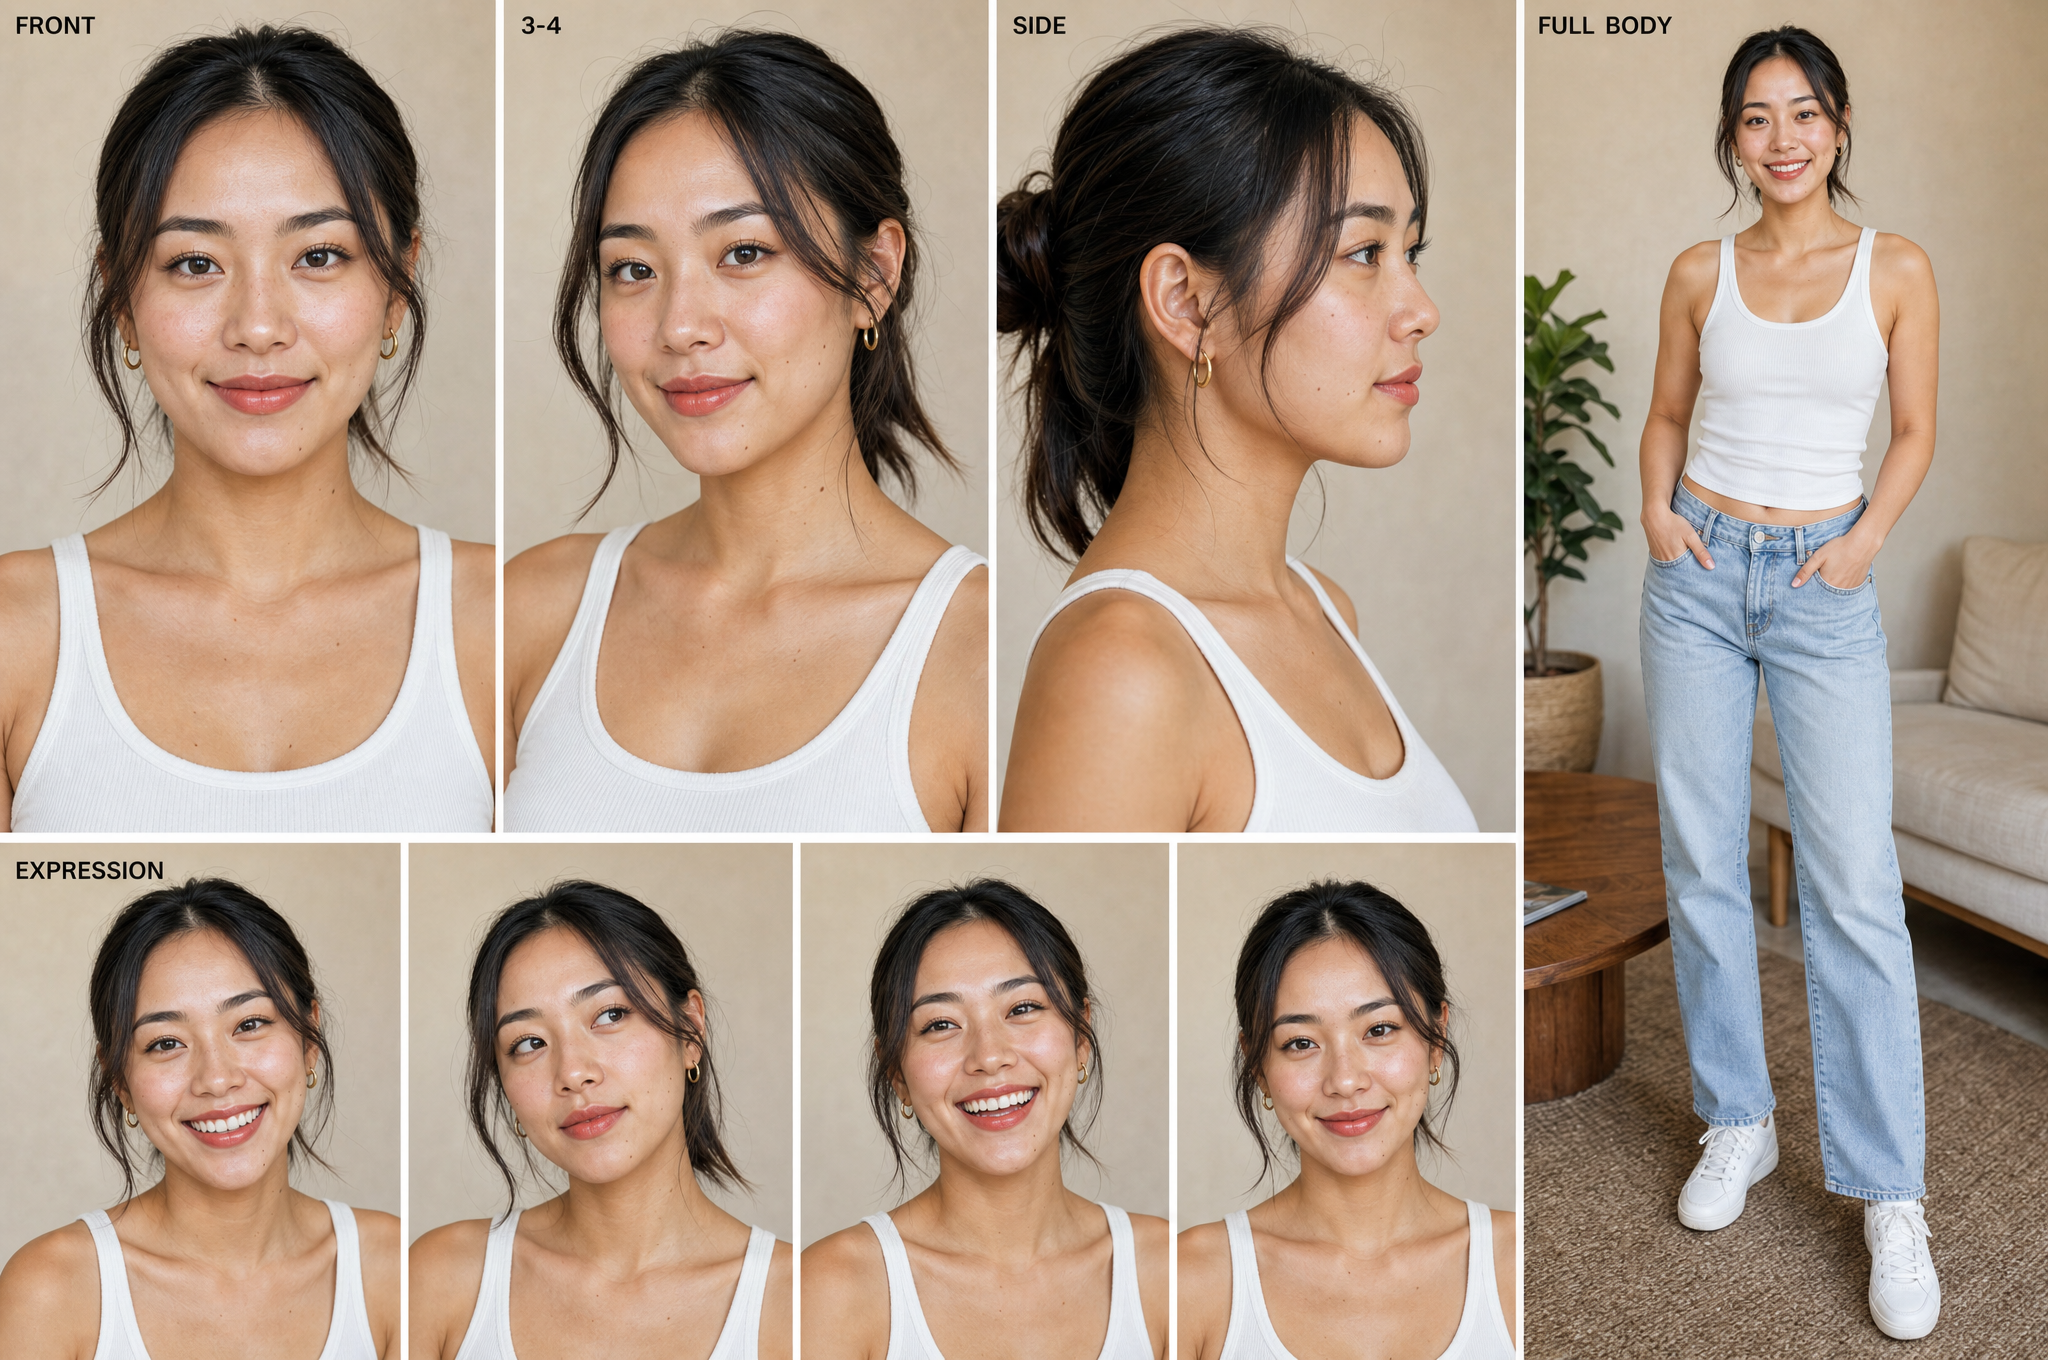
즉, 아래의 순서로 변경된 것이죠.
- 스케치기반 콘티 제작: 영상에 스토리라인을 결정
- 인물 및 사물 마스터시트 제작: 정면샷, 얼굴, 측면샷, 표정 변화 등을 포함 (GPT Image 2)
- 영상 제작: Higgsfield 와 같은 MCP 기반 영상 제작
모델이 모르는건 어떻게 알려줄까?
콘티를 완성하고 나니 립의 캡 방향, 어플리케이터 팁 모양, 컵을 마시는 포즈가 아닌 벽면에 입술 자국을 내는 샷은 계속 실패했습니다. 왜 그럴까? 생각해보면 이유는 명확합니다. 모델이 이런 데이터를 학습한 적이 없죠. 립은 신제품이었으니.. 당연히 데이터가 없었을 것이고 컵에 뽀뽀를 하는 사람보다는 마시는 제스처를 취하는 데이터가 적었을 겁니다. 제품의 상세 페이지의 여러 이미지를 주고 생성하고 수정해도 크레딧은 더 쓰는데 99점 이상 줄만한 결과는 나오지 않았습니다. 결국 제가 직접 찍은 실사 사진을 제공해서 마스터시트를 만들었고, 이를 master-sheet 스킬에 녹였습니다. 완벽하게 하기 위해서는 AI 가 뭘 구별 못 하는지 알고 그걸 정확하게 집어주는 데이터가 필요합니다. 그래서 저는 양쪽 립이 닫히고 열려있는 모습을 정확히 캐치할 수 있는 시트를 추가했습니다. 컵도 임의로 옆에서 입술 자국을 남기도록, 그것도 윗입술만 남기도록 했습니다.
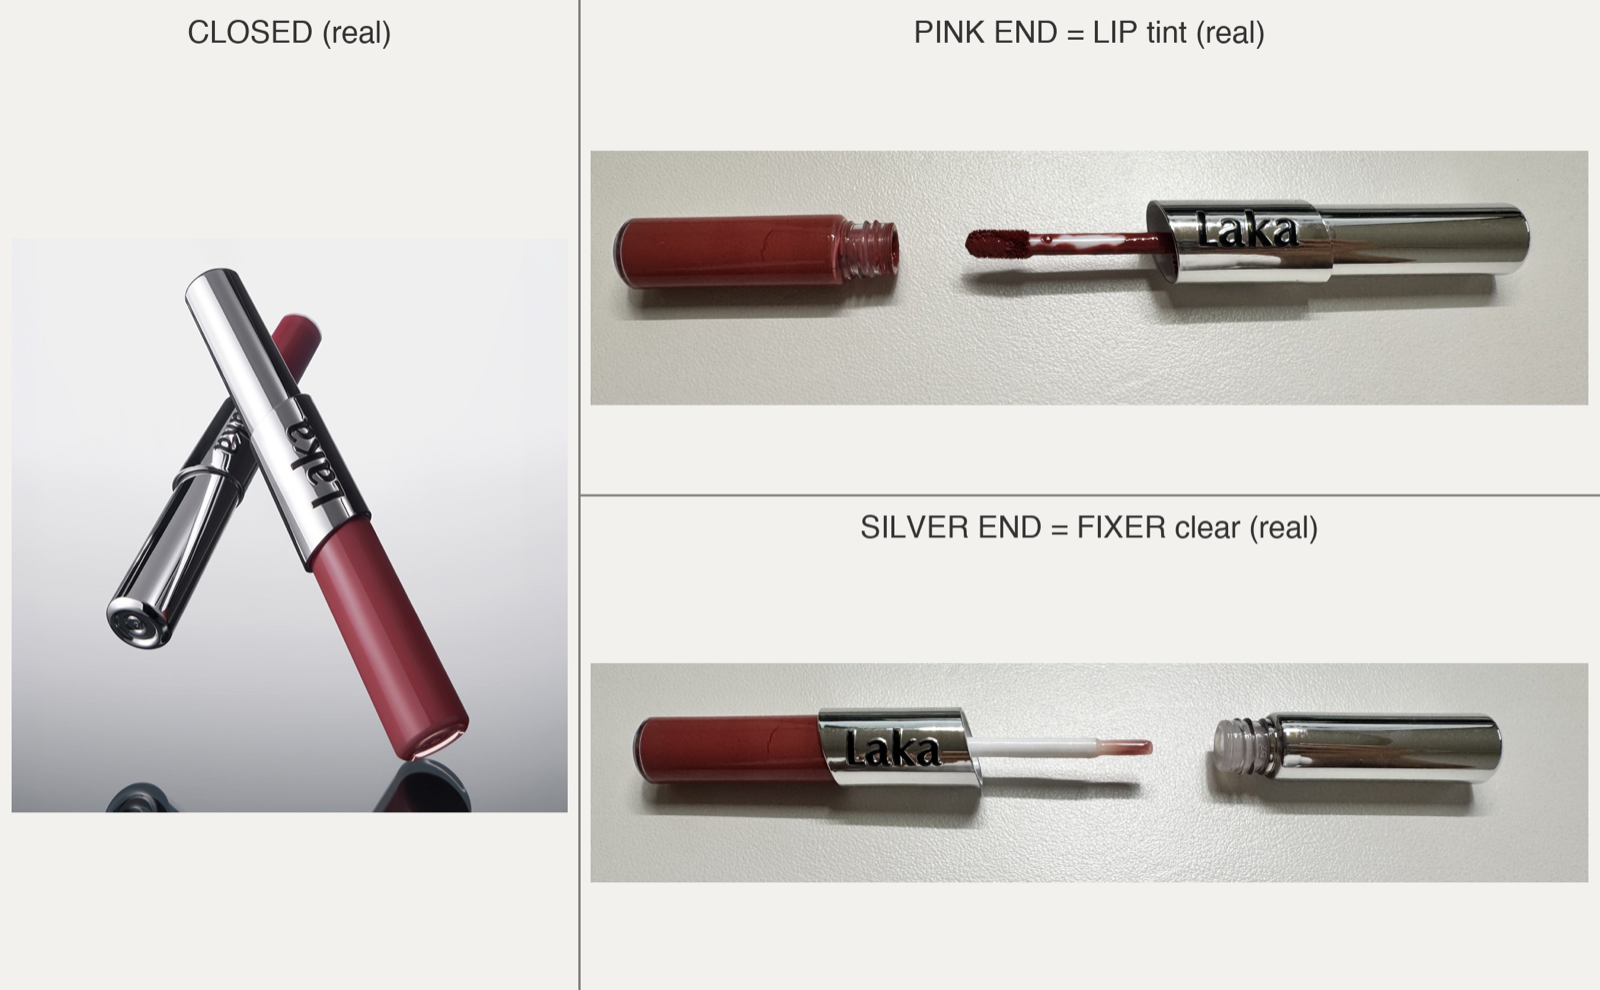
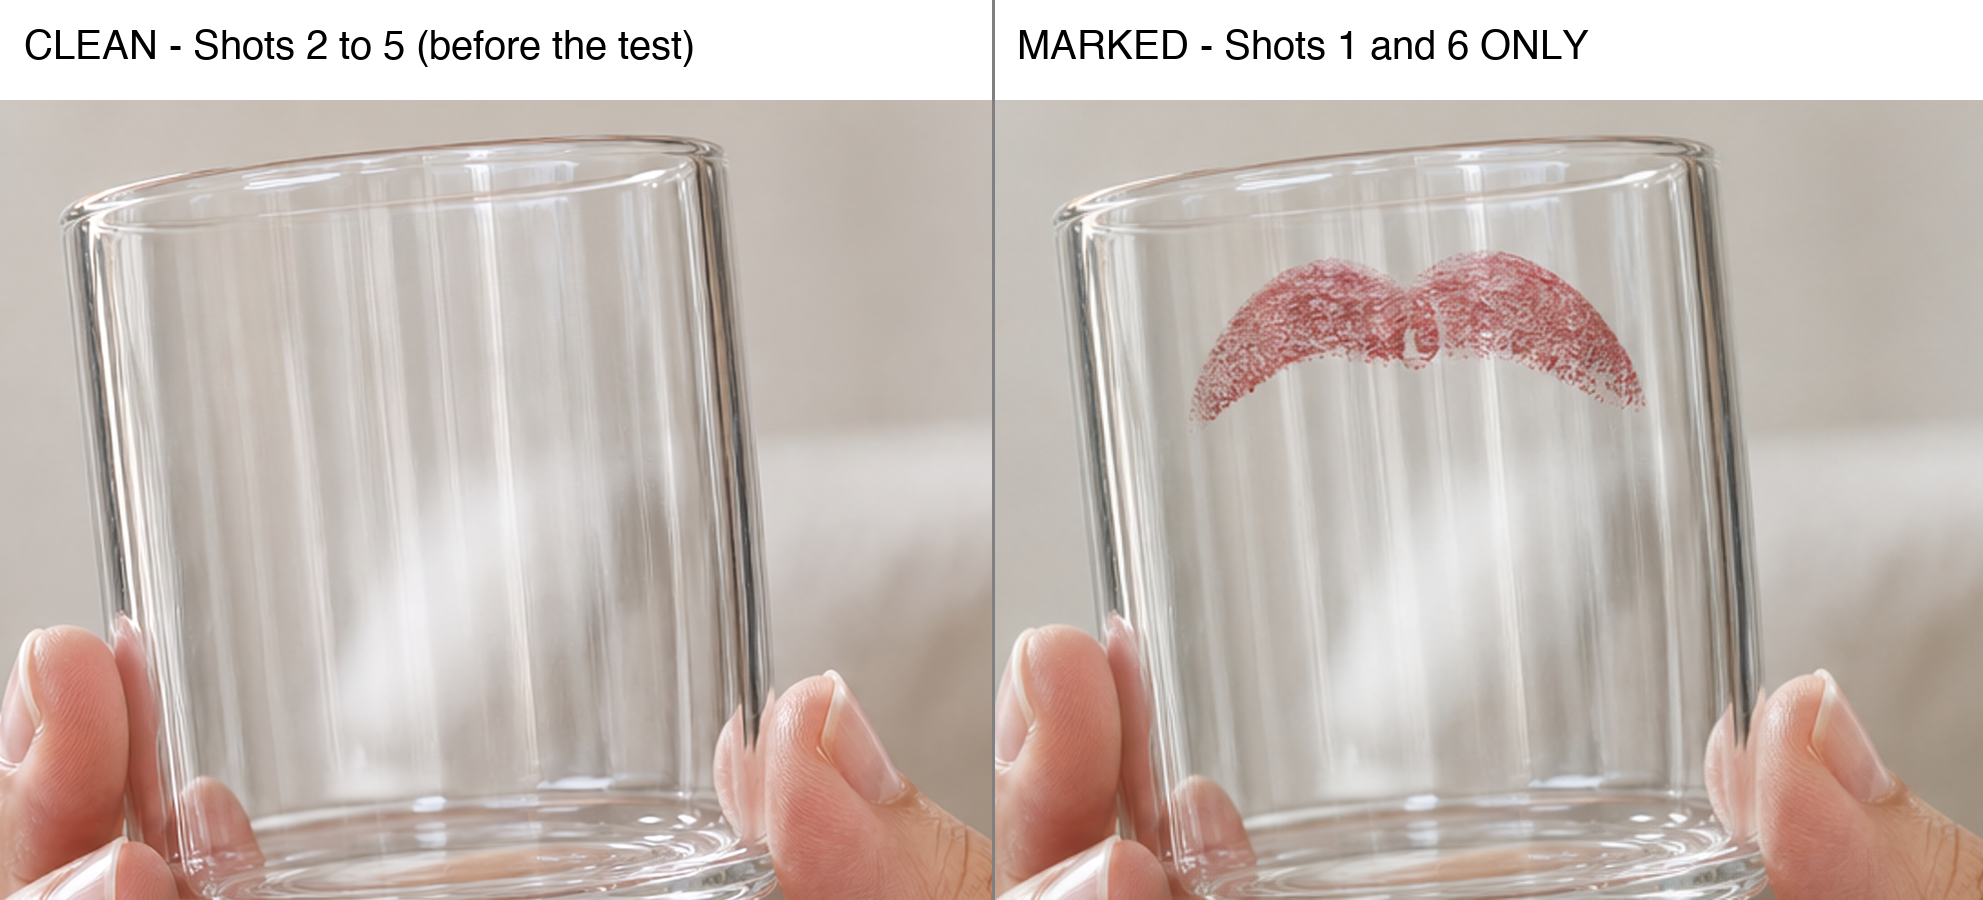
상태나 역할이 달라지는 요소(유리잔의 CLEAN/MARKED, 제품의 LIP/FIXER)는 라벨이 붙은 상태 시트 하나로 만들고, 실제 Seedance 생성 프롬프트에서 “몇 번 샷에 어떤 상태인지”를 적어서 주었습니다. 이제 리뷰는 그림과 라벨이 서로 모순되지 않는지만 확인하면 됩니다.
SKILL로 일반화: Don’t reinvent the wheel
개발자들이 환장하는 문구입니다. 유연하게 설계한 워크플로우는 어떤 상황에 어떤 영상을 제작하더라도 대응이 가능합니다. 이 다음엔 Claude Code 스킬로 저장할 차례입니다.
storyboard병합: 형식을 하나의 스케치 폼으로 고정master-sheet에 세 가지 추가: (1) 확정된 콘티 표에서 화면에 등장하는 모든 요소를 뽑는 게이트(컵과 소품도 여기서 결정), (2) 실물 우선(실물이 있으면 생성하지 말고 합성), (3) 정밀 정렬 리뷰. 전체 파이프라인에서 픽셀 단위로 보는 유일한 단계. 자국 위치나 소품 디자인 같은 픽셀 체크도 포함- 리뷰 게이트 이동: 스케치는 썸네일 수준이니 표와 대조만(라벨, 타임코드, 모순).
시작할 때 말씀드렸지만 하나의 단계가 하나의 책임을 져야 하니 각 스텝의 결과물을 사람이 꼼꼼히 리뷰하는 건 매우 중요합니다. (각 단계에서 놓친건 결국 다 되돌아 옵니다.)
결과
이렇게 만들어진 결과물은 꽤나 자연스러웠습니다. 유리잔 상태 타임라인, 입술을 대는 포즈, 제품 양쪽 끝의 사용 순서, 마지막 리액션, 캐릭터 일관성까지 전부요. v1-v3에서 하나씩 깨지던 것들이, 채널을 분리하자 한꺼번에 맞아떨어졌습니다.
v4 (480p 테스트 · 15초 · 채널 분리 파이프라인)